레이블이 machine learning인 게시물을 표시합니다. 모든 게시물 표시

2022년 5월 13일 금요일

[PR12 Video] 385. Generative Modeling by Estimating Gradients of the Data Distribution


TensorFlowKR facebook comunity에서 모인 12명의 paper readers (PR12)가 읽어주는 deep learning papers

#385. Generative Modeling by Estimating Gradients of the Data Distribution


PR12 385번째 발표입니다. 요즘 하도 Diffusion model이 잘 되길래 이거 공부를 하긴 해야하겠는데..하다가 좀 각잡고 봐야겠다고 마음 먹었더니 NeurIPS 19년 논문으로 갔습니다. 사실 2005년에 나온 논문부터 해야하지만 발표를 위해 적절히 타협을..ㅎㅎ 재미있는 논문입니다. 보시면 Score-based generative model이 뭔지 아실 수 있으리라 생각합니다.


Paper:  https://arxiv.org/abs/1907.05600

다른 분들의 발표도 보고 싶다면 아래 링크에서 확인하시면 되겠습니다 :)
* 현재 4기가 진행 중입니다!


다음 읽을거리


2022년 3월 5일 토요일

[PR12 Video] 374. Fourier Features Let Networks Learn High-Frequency Functions in Low Dimensional Domains (+ NTK, Neural Tangent Kernel)


TensorFlowKR facebook comunity에서 모인 12명의 paper readers (PR12)가 읽어주는 deep learning papers

#374. Fourier Features Let Networks Learn High-Frequency Functions in Low Dimensional Domains


PR12 374번째 발표입니다. 오늘도 저번처럼 가면 갈수록 inductive bias를 줄여야한다고 외치고 있는 연구 방향과는 정반대로, 이론에 근간한 간단한 fix를 통해 훨씬 강력한 성능을 달성한 모델을 소개해보겠습니다. 매우 즐겁게? 읽었는데요. 다른 분들도 재미있으셨으면 좋겠습니다. (네...제가 그렇죠 뭐. 오늘도 매우 어려운 논문을 골라놓고 내일이 개강인데....난 왜 이 논문을 골라서 스스로 괴롭게 살까 계속 그 생각만 하면서 준비했습니다. 담부턴 좀 쉬운 논문 해야지 하면서 맨날 스스로도 소화하기 힘든 논문을 고르는건 과학인듯 합니다.) (꼭 고를 때 되면 쉽게 할 수 있어보이더라) (다 하보니 1시간...)


Paper:  https://arxiv.org/abs/2006.10739

다른 분들의 발표도 보고 싶다면 아래 링크에서 확인하시면 되겠습니다 :)
* 현재 4기가 진행 중입니다!


다음 읽을거리


2021년 8월 12일 목요일

[PR12 Video] 338. Alias-Free Generative Adversarial Networks (StyleGAN3) 리뷰 개념 정리


TensorFlowKR facebook comunity에서 모인 12명의 paper readers (PR12)가 읽어주는 deep learning papers

#338. Alias-Free Generative Adversarial Networks


PR12 338번째 발표입니다. 오늘도 저번처럼 가면 갈수록 inductive bias를 줄여야한다고 외치고 있는 연구 방향과는 정반대로, 이론에 근간한 간단한 fix를 통해 훨씬 강력한 성능을 달성한 모델을 소개해보겠습니다. Nvidia의 Tero Karras가 1저자인 논문입니다. 🙂 매우 즐겁게? 읽었는데요. 다른 분들도 재미있으셨으면 좋겠습니다. (너무 많은 내용을 하나에 담아서 설명하려고 했나 하면서 후회하고 있습니다 ㅋㅋ 힘들었어요...담부턴 좀 쉬운 논문 해야지 하면서 맨날 스스로도 소화하기 힘든 논문을 고르는건 무슨 이유일까요..orz)


Paper:  https://arxiv.org/abs/2106.12423

처음 PR12를 시작했을 때는 대학원생, 1기 마지막 발표 때는 네이버, 얼마 전까지는 EPFL에서 포닥, 이제 드디어 UNIST에서 조교수로 시작합니다. PR12와 제 커리어가 같이 흘러가는군요. 열심히 해보겠습니다. 다른 분들의 발표도 보고 싶다면 아래 링크에서 확인하시면 되겠습니다 :)
* 현재 4기가 진행 중입니다!


다음 읽을거리


[PR12 Video] 323. Separation and Concentration in Deep Networks


TensorFlowKR facebook comunity에서 모인 12명의 paper readers (PR12)가 읽어주는 deep learning papers

#323.Separation and Concentration in Deep Networks


오늘도 저번처럼 가면 갈수록 big model로 치닫고 있는 연구 방향과는 정반대로, 학습이 거의 없이 ImageNet에서 ResNet classification 성능을 제치는 모델을 소개해보겠습니다. NYU의 Joan Bruna와 신호처리의 거장 중 한명인 Stephane Mallat 교수님의 scattering network에 대해 아신다면 더 잘 이해가 가실 것 같습니다 🙂 매우 즐겁게 읽었는데요. 다른 분들도 재미있으셨으면 좋겠습니다.


Paper:  https://openreview.net/forum?id=8HhkbjrWLdE
슬라이드: https://www.slideshare.net/thinkingfactory/pr12-generative-models-as-distributions-of-functions

4기 되어 두번째 발표입니다. 다른 분들의 발표도 보고 싶다면 아래 링크에서 확인하시면 되겠습니다 :)
* 현재 4기가 진행 중입니다!


다음 읽을거리


2021년 4월 12일 월요일

[PR12 Video] 312. Generative Models as Distributions of Functions


TensorFlowKR facebook comunity에서 모인 12명의 paper readers (PR12)가 읽어주는 deep learning papers

#312.Generative Models as Distributions of Functions


오늘은 2021년 2월에 arXiv에 올라온 Generative Models as Distributions of Functions 논문을 리뷰하겠습니다. 1기 이후 오랜만에 PR12 멤버로 합류하게 되었는데요. 가면 갈수록 big model로 치닫고 있는 연구 방향과는 정반대로, 상당히 독특한 형태로 재미있게 생성 문제를 풀은 연구를 소개해봤습니다. 저는 개인적으로 매우 즐겁게 읽었는데요. 다른 분들도 재미있어 하시면 좋겠습니다.


Paper:  https://arxiv.org/abs/2102.04776
슬라이드: https://www.slideshare.net/thinkingfactory/pr12-generative-models-as-distributions-of-functions

처음 PR12를 시작했을 때는 대학원생, 1기 마지막 발표 때는 네이버, 지금은 EPFL에서 포닥, 곧 UNIST에서 조교수로 PR12와 제 커리어가 같이 흘러가고 있는걸 보니 또 나름 감회가 새롭네요. 다른 분들의 발표도 보고 싶다면 아래 링크에서 확인하시면 되겠습니다 :)
* 현재 4기가 진행 중입니다!


다음 읽을거리


2019년 5월 17일 금요일

Deep Learning for Super-Resolution: A Survey (1)

Image Super-Resolution(이하 SR)은 컴퓨터 비전 분야의 중요한 갈래 중 하나로 이미지나 비디오의 해상도를 좋게 하는 영상처리 기술을 말합니다. 영화나 미드에서 위성 사진을 바탕으로 계속 확대해보라고 하는 장면이 종종 나오는데요, 이런 클리셰를 너무 많이 써먹은 나머지 아래와 같은 짤방이 만들어질 정도로 우리에게 SR은 꽤나 친숙한 기술입니다.


짤방에서는 비현실적인 예시로 클리셰를 비꼬고 있지만 최근 Deep learning을 이용한 SR 기술들을 보면 우리가 생각하는 것 이상으로 기술이 빠르게 발전하고 있다는 것을 알 수 있습니다.
“Any advanced technology is indistinguishable from magic”.
- Arthur C. Clarke
한 때 잠시 SR을 했었고 다시 또 SR에 관심을 가지게 되면서, 최신 연구 동향을 파악하고 스스로의 공부를 위해 정리 글을 작성해보고자 합니다.

Single Image Super-Resolution 


SR에는 Single Image(SI)를 이용한 방법 외에도 Multiple Images를 이용한 방법들 역시 많이 연구되었으나 이 글에서는 SISR 에서 external-example based methods에 속하며 그 중에서도 deep learning model을 사용한 연구에 집중하여 리뷰합니다. Survey의 형식이기 때문에 세세하게 설명하기 보다는 굵직한 모델들의 컨셉을 소개하고 전체적인 흐름을 위주로 짚어가며, 각 모델들에 대한 자세한 내용은 필요한 경우에 한해서만 다룰 생각입니다 (**).

Single Image Super-Resolution(SISR)은 한 장의 저해상도 이미지(low resolution image, LR)를 가지고 고해상도의 이미지(High resolution image, HR)를 만들어 내는 대표적인 low-level vision 문제입니다. 의료 영상에서부터 감시 카메라 및 보안 영상 등에 다양하게 적용이 가능한 기술이기에 컴퓨터 비전 분야에서 전통적으로 매우 중요하게 다뤄져 왔습니다.

Problem Definition


SISR에서 LR 이미지 $y$에 대한 수학적 모델은 일반적으로 다음과 같이 정의됩니다:
$$y = (x ⊗ k)↓s + n.$$ $x$와 $k$는 각각 우리가 모르는 원본 HR 이미지와 이에 씌워지는 (convolved) degradation or blur kernel입니다. 이렇게 degradation이 일어난 $x$에 $s$만큼 downsampling ($↓s$)되고 system noise $n$가 더해져서 LR image $y$가 얻어진다고 생각할 수 있습니다.

문제는 하나의 LR 이미지 $y$에 대응될 수 있는 HR 이미지 $x$가 매우 다양할 수 있기 때문에 SISR이 대표적인 ill-posed problem라는 점입니다 (**). 전통적으로는 sparsity나 image statistics를 이용한 prior knowledge를 기반으로 문제를 푸는 optimization 방법들이 활발히 연구되어 왔지만, 최근 Deep learning을 적용되면서 분야 전체가 믿기 힘들 정도로 더욱 빠르게 발전하고 있습니다. 단순히 deep network를 적용하는 것뿐만 아니라 전반적인 모델framework부터 데이터 전,후처리 방식, upsampling 방식 등 매우 다양한 방면으로 연구 및 발전이 이루어지고 있는 것을 보실 수 있습니다.
** 전통적인 SISR 방식에 대해 궁금하다면 (이 글)을 참고하시면 됩니다.
** why? 좀 더 자세하게 알고싶다면 (이 글)을 참고하시면 됩니다.


SRCNN: The Start of Deep Learning in SISR


언제나 그렇듯 각 분야마다 deep learning을 처음으로 도입한 cornerstone이 되는 연구가 하나씩 있기 마련인데요 SISR 분야에서 최초로 CNN을 적용한 연구는 SRCNN(Dong et al.)으로 이름도 찬란한 Kaiming He가 저자 중 1인입니다. (이 양반은 안 끼는데가 없네..)

요즘 나오는 모델들에 비교한다면 deep network라는 이름도 무색할만큼 매우 적은 channel과 layer 수를 갖는 매우 작은 네트워크라는 것을 볼 수 있는데요. 그럼에도 불구하고 여전히 눈여겨 볼 점은, 당시 state-of-the-art 알고리즘들을 큰 차이로 이기고 새로운 baseline을 개척했다는 점, 제안한 3개 layer짜리 SRCNN 구조가 empirical heuristic에 근거한 것이 아닌 전통적인 sparse coding method와의 연관성을 바탕으로 고안되었다는 것입니다. (혹은 최소한 그런 링크가 있다고 매우 그럴 듯하게 주장했ㄷ...)

SRCNN

그림에서 보실 수 있듯이 CNN에서 data-driven filter를 이용한 각각의 nonlinear transformation들이 전통적인 방식에서의 patch extraction, nonlinear mapping (from LR to HR patches) 그리고 reconstruction step에 대응된다고 얘기하고 있습니다:

1. Patch extraction and representation: LR 이미지에서 patch들을 추출해서 high dimensional feature vector로 표현하는 단계; 전통적으로는 PCA나 DCT, Haar 등을 사용해서 추출된 patch들을 pixel representation이 아닌 feature로 represent합니다. 이 과정 자체가 이미지 $\mathbf{Y}$에 특정 filter들을 사용하여 convolution operation을 수행하는 것으로 생각할 수 있으므로 아래와 같이 표현이 가능할 것입니다: $$F_1(\mathbf{Y}) = max(0,W_1 * \mathbf{Y} + B_1)$$ 2. Non-linear mapping: High dimensional feature space (e.g. LR patch space)의 patch들을 또 다른 high dimensional feature space (e.g. HR patch space)로 mapping해주는 단계; 하나의 feature space에서 다른 feature space로 mapping해주는 것 역시도 change of basis로 생각하면 learned basis 혹은 filter를 이용한 convolution operation으로 나타낼 수 있겠습니다: $$F_2(\mathbf{Y}) = max(0,W_2 * F_1(\mathbf{Y}) + B_2)$$ 3. Reconstruction: mapping된 feature vector를 바탕으로 HR 이미지를 만들어내는 단계; 마지막으로 feature domain에서 HR image domain으로 averaged output 생성입니다. 마찬가지로 convolution operation으로 표현이 가능합니다: $$F(\mathbf{Y}) = W_3 * F_2(\mathbf{Y}) + B_3$$
여기서 한가지 더 주목할 부분은 이전의 방식들이 각각의 단계를 처리하는 여러 알고리즘들이 종합적으로 합쳐져서 SR 문제를 풀었다면, SRCNN은 최초의 end-to-end 방식으로써 모든 step을 하나의 통합된 framework에서 처리한다는 것입니다. 특히 매우 단순 명료한 방법으로 기존의 신호처리 관점에서 바라보던 SISR 문제를 deep learning의 관점에서 풀어내면서도 양쪽을 이어주는 가교 역할을 했다는 것에 의의가 있습니다.

Problems to solve


SRCNN은 이후 CNN을 사용한 SISR methods들에 좋은 영감을 주었는데, (아아 그는 좋은 baseline이었다) 이후 나온 Deep learning 방식들은 큰 줄기에서 보면 모두 SRCNN의 단점들을 보완하기 위한 방향으로 발전되었습니다. 각각의 단점들을 크게 정리하면 아래 세 가지로 나눌 수 있습니다:
  1. Bicubic LR
  2. Shallow (three-layer) network
  3. Naive prior in the model

1. Bicubic LR

마지막에 HR 크기로 (최소한 비슷한 **) 이미지를 맞추기 위해 SRCNN은 먼저 bicubic upsampling을 적용한 LR 이미지를 input으로 사용합니다. 논문에서는 bicubic upsampling이라는 operation 자체도 또 하나의 deterministic convolution layer라고 할 수 있다고 설명합니다만 이렇게 upsample이 적용된 LR input을 주는 것으로 여러 애로사항이 꽃 피게 됩니다;
** 사실 SRCNN에서는 padding이 없어서 convolution layer를 지날 때마다 feature map size가 줄어든다.
1) 일단, bicubic upsampling을 LR에 적용해서 준다는 점 자체가 HR 이미지에 대한 degradation model에 대한 implicit prior를 주게 됩니다. 이로 인해 estimation bias가 생깁니다. 따라서 downsampling 혹은 degradation model이 bicubic이 아닌 알지 못하는 좀 더 realistic한 setup에서 학습된 모델의 성능이 저하되는 것을 막을 수 없지요.
2) 또한 처음부터 input size를 크게 사용하기 때문에 computation cost가 늘어나고 따라서 모델이 느려질 수 밖에 없습니다.

2. Shallow network

2014년이라는 시점을 생각하면 매우 당연한 일이기는 합니다만 SRCNN은 더 많은 데이터와 깊은 모델을 사용하면 좋은 성능을 보일지도 모른다는 가능성을 얘기하면서도, 실제로 그런 모델이 잘 동작한다는 것을 보이지는 못했습니다. (오히려 깊은 네트워크에서 성능이 떨어진다는 것을 보였지요) 따라서 이후 많은 연구들이 어떻게 하면 성능 향상을 위해 깊은 네트워크를 학습시킬 수 있을지에 대해 집중하였고, 이후 소개할 VDSR(very deep SR network)를 기점으로 다양한 모델들이 제안되었습니다.

3. Naive prior

앞서 첫번째에서 얘기한 것과 비슷한 맥락으로, SRCNN의 학습 방식은 network architecture에 대한 통찰력 있는 분석에 비해서는 좀 아쉬운 점이 있습니다. 단순히 최종 output과 HR 이미지의 MSE를 줄이는 모델을 바탕으로 학습하는데, SISR이라는 문제에 적합한 prior knowledge를 모델 디자인이나 loss 함수에 이를 적절히 녹여넣어 보다 나은 성능을 얻을 수 있지 않을까라는 질문을 할 수 있겠습니다. 이에 답하기 위해, 역시 이후 많은 연구들이 multi-scale learning 등의 다양한 framework들을 제안하였습니다.

Deep models for SISR


SRCNN이 매우 초기 연구고 여러가지 단점이 있지만 최신 모델들이 갖고 있는 중요한 요소들은 모두 갖추고 있습니다.  이런 관점에서 SRCNN을 큰 부분으로 나눠보면, upsampling methods, model framework, network design, learning strategy의 조합으로 이루어졌다는 것을 알 수 있는데요. 이제부터는 위에서 소개한 문제를 해결하기 위해 각 요소가 어떤 방향으로 발전되고 있는지 하나씩 정리해보겠습니다.

1. Upsampling methods


결국 SISR이라는 문제가 LR에서 HR 이미지로 크기를 키우는 방법을 연구하는 것이므로 먼저 주목을 받은 것은 CNN에서 이미지 크기를 "어떻게 키울 것인가"  입니다.

1) Interpolation-based Upsampling
가장 먼저 고려되었던 방식은 당연하게도 전통적인 interpolation입니다. 이런 upsampling 방식은 implementation이 쉽고, interpretable하다는 장점이 있어 pre-processing으로 많이 사용되었습니다:
  • Nearest-neighbor interpolation
  • Bilinear Interpolation
  • Bicubic Interpolation
그러나 전통적인 interpolation은 external data 정보를 이용하지 못하고, 따라서 dataset이 많을 때 기대할 수 있는 이점이 없기에 deep learning에서 추구하는 바와는 잘 맞지 않았습니다. 게다가 각 방식의 특성에 따라 blurring이나 noise amplification 등이 추가되는 경우가 있어서 초기에만 사용되었습니다. 

2) Learning-based Upsampling
위와 같은 문제들을 피하기 위해 SISR에서는 점차 upsampling operation 자체를 학습하는 방향으로 연구가 진행되었는데, 대표적인 예로는 두 가지 방식이 있습니다:
  • Transposed Convolution Layer
  • Sub-pixel Layer
Transposed Convolution Layer는 흔히 Deconvolution Layer라고도 불립니다. (다만 이러한 명칭에는 전통적으로 영상신호처리 얘기하는 deconvolution과 관련성이 없고 이름이 겹치며 실제 operation을 제대로 설명하고 있지 않다는 문제점이 있기에 Transposed Convolution이라는 표기를 더 선호합니다) 

SISR 분야에서 처음으로 Transposed Convolution을 사용한 연구는 SRCNN의 1저자 Dong이 후속으로 발표한 FSRCNN(Fast SRCNN)입니다. 명확한 이해를 위해서 먼저 각 operation에 대해 설명하는 그림을 보면 아래와 같습니다 (Fig. 4):

모든 learnable 방식이 공유하는 장점이겠으나, Transposed Convolution은 downsampling kernel이 알려지지 않았을 때, 단순한 interpolation 방식(handcrafted implicit prior)을 쓰는 것보다 더 나은 성능을 보여줍니다. External data로부터 정보를 얻을 수 있을뿐더러 부정확한 estimation으로 인한 side effect도 피할 수 있다는 장점이 있었기에 지금도 많은 모델에서 사용되고 있습니다.

한편, Sub-pixel Layer는 Transposed Convolution이 expanding 단계 이후 convolution operation을 할 때, 중복하여 계산되는 pixel이 많아 계산량에서 손해를 보는 단점이 있다는 것을 지적하고 이를 개선하기 위해 제안되었습니다. 그림(Fig. 5)에서 볼 수 있듯이 1) 계산하고자 하는 pixel을 channel쪽으로 밀어넣고, 2) 마지막에 pixel들의 위치를 배치하는 방식을 사용하여 매우 단순하지만 효과적인 방식으로 중복 연산을 없앴습니다.
** 기존 Transposed Convolution의 expanding 단계에서 추가되는 pixel이 nearest neighbor가 아닌 zero padding일 때, Sub-pixel 방식이 Transposed Convolution과 같아진다는 것을 알 수 있습니다.

이렇듯 Sub-pixel 방식은 계산이 효율적이기 때문에 많은 모델에서 사용되고 있습니다. 다만 일반적으로 Sub-pixel 방식은 학습 이후 gridding artifact가 생긴다는 점이 단점으로 지적되고 있어서 다른 variations를 찾는 연구들 역시 제안되고 있습니다.
** 이쪽은 관심이 없는지라 더 깊이 살펴보지는 않았습니다만 관심있으신 분들은 "Checkerboard artifacts free convolutional neural networks"와 논문을 보시면 되겠습니다. 

2. Model framework


한편 전반적인 model framework 관점에서 upsampling module을 어디에 놓는 것이 좋을 지에 대해서도 다양한 연구가 있었습니다. 이들을 크게 네 갈래로 나누자면 아래와 같습니다:
  1. Pre-upsampling
  2. Post-upsampling
  3. Progressive upsampling
  4. Iterative up-and-down sampling
이름에서도 명확히 드러나듯이 모델마다 upsampling을 앞 혹은 뒤에 놓는 것에 따라 특징이 있는데 각 방식에 대한 장단점을 분석해보겠습니다.

Pre-upsampling: 가장 초기에 사용된 방식입니다. 처음 upsampling을 한 이후 네트워크의 input과 output 크기가 동일하게 유지되기 때문에, 계산량에서 손해를 보므로 대다수의 후기 연구들에서는 사용하지 않게 되었습니다.
** 그러나 이것이 꼭 단점만은 아닐 수도 있습니다. 계산량과는 별개로 practical implementation 관점에서 input과 output의 크기가 같다는 점이 주는 장점이 있죠. Input의 크기가 원하는 output 크기와 같기 때문에 다양한 배율(scale)에 대해서 같은 네트워크를 적용할 수 있게 됩니다. 이후 소개를 하겠으나 x2, x3, x4, x8 등의 다양한 scale dataset을 모두 사용하는 multi-scale learning을 적용할 때, 이런 형태의 model framework은 input 크기를 바꿔주는 것이 deterministic하고 따라서 네트워크에 대한 별다른 구조적 변화를 고려하지 않아도 된다는 장점이 있습니다.  

Post-upsampling: 앞서 잠시 언급했던 FSRCNN이 바로 이런 형태였습니다. Transposed Convolution을 사용하여 네트워크 마지막 부분에서만 upsample을 하기 때문에 앞에 대다수의 연산이 작은 feature space에서 이루어지고, 이로 인해 학습이 빨라지고 안정될 뿐만 아니라 계산량에서 큰 이득을 보게 됩니다. 이런 장점들로 인해 이후 거의 대부분의 모델들이 Post-upsampling 방식을 사용하고 있습니다.

Progressive upsampling: Post-upsampling 방식들은 마지막에서 한 번에 HR 이미지 크기로 올린다는 특징 때문에 배율이 높은 SR(e.g. x8) 모델 학습이 어렵습니다. 각 배율마다 별개의 네트워크가 필요하기에 multi-scale SR을 하는 모델에도 적합하지 않구요. 이런 문제들을 해결하기 위해 단계적으로 (progressively) 크기를 증가시키는 모델들이 제안되었고 CVPR 2017에 발표된 Laplacian pyramid SR Network (LapSRN)과 CVPR 2018에 발표된 Progressive SR (ProSR)이 그 대표적인 예시들입니다.
LapSRN 구조

이런 모델들의 경우 단일 모델이 한 번의 feed-forward 연산으로 여러 배율(x2, x4, x8 등)의 이미지를 만들 수 있어서 다른 방식에 비해 더 경제적인 multi-scale SR이 가능합니다. 
** 개인적으로 LapSRN과 같이 전통적인 Laplacian pyramid와 Deep model을 결합한 방식의 연구를 매우 좋아하는데, 한편으로는 매우 아쉬운 것이 같은 생각을 하여 모델을 만들었었다는 점입니다. 그리고나서 이 모델을 발견하고 세상에 새로운 것이라고는 없다는 것을 다시 한 번 깨달았습니다...orz.. 

Iterative up-and-down sampling: 이 model framework은 매우 최근에 제안된 모델 때문에 생긴 갈래로, CVPR 2018에 발표된 Deep Back-Projection Network (BPDN)입니다. Super-resolution competition으로 유명한 NTIRE workshop에서 2018년 우승(classical task)을 한 모델로 Bicubic downsampling track에서 뛰어난 성능을 보여주었습니다. LR-HR 이미지 간의 관계를 좀 더 잘 학습하기 위해서 optimization 분야의 iterative method들로부터 영감을 얻어 네트워크에 적용하였습니다. LR과 HR 이미지 domain 간에 up (projection)-and-down (back-projection) mapping을 반복하면서 최종 결과가 점차 개선되기를 기대해볼 수 있습니다.
** 저는 의료 영상 분야에서 와서 그런지 back-projection이 매우 익숙한 방식인데, 점차 이와 같은 classical optimization technique들을 deep learning model에 녹여넣는 형태의 연구들이 많이 소개되는 것으로 보입니다.
** Progressive와 iterative model framework는 모두 성능에서 좋은 향상을 불러왔지만 모델 구조가 복잡하고 학습이 어려워졌다는 단점이 따라오게 됩니다만, 개인적으로 이런 방향의 연구가 다른 framework들에 비해서 앞으로 좀 더 유망하다고 생각합니다. 

3. Network Design


Network design은 SISR 모델에 대한 연구에서 단연 가장 많은 분량을 차지하고 있는 요소이며 classical deep model의 발전과 함께 다양한 구조들이 시도되었습니다:


다양한 SISR 모델 구조 도식 [3]

위 그림에서 보여드리는 네트워크들은 SISR 모델로 제안된 수많은 연구들 중 일부에 불과합니다. 그러나 다행하게도! 이들을 잘 정리해보면, 대략 아래와 같이 큰 줄기로 나누어 정리할 수 있습니다:


SISR 모델 카테고리 [2]

Residual learning
Network design을 살필 때 가장 먼저 언급이되는 논문은 자랑스럽게도 한국인이 저자인 Very Deep SR network (VDSR, CVPR 2016)입니다. 현재 SK에 상무로 계시는 김지원님이 서울대 이경무 교수님 연구실에서 학생이던 때 발표한 모델인데요. SISR 분야 연구에 대해 얘기할 때면 SRCNN과 함께 가장 먼저 나오는 모델 중 하나이며, 여기서 제안된 residual learning은 지금도 여전히 많은 모델들이 사용하고 있는 방식입니다.

VDSR은 SRCNN과 같이 SISR의 cornerstone paper 중 하나로 가장 처음으로 SISR에 학습 가능한 깊은 모델을 제안하였습니다. VGG 네트워크 구조를 차용하여 20개 layer를 쌓아 학습을 시켰고, 깊은 모델의 학습을 위해 두 가지를 제안하였는데 첫째는 global residual learning이고 둘째는 gradient clipping을 동반한 adjustable high learning rate입니다.

이 중 residual learning은 여전히 사랑받고 있는 방법으로 위 그림에서 볼 수 있듯이 학습이 LR 이미지에서 HR 이미지로 mapping하도록 하는 것이 아닌 bicubic upsampled LR 이미지와 HR 이미지의 잔차(residual) 혹은 noise를 학습하는 방식을 제안합니다. (주의할 점은 ResNet의 residual과는 약간 결이 다르다는 점입니다. 이 맥락에서 ResNet은 보다 local residual learning을 수행한다고 할 수 있겠네요.)

Residual image로 학습 대상을 바꾼 것은 full HR 이미지보다 만들어야 하는 정보가 적기에 SISR 문제를 상대적으로 쉬운 문제로 치환하는 효과를 주었습니다. 이로 인해 deep network의 학습이 안정적이고 가속되면서도 성능에 매우 큰 향상이 가능해졌고 이후 많은 모델들이 동일한 전략을 취해 비슷하게 성능 향상을 report하였습니다.
** 같은 맥락에서 제가 CVPR 2017에 발표했던 Wavelet-based SR network에서도 네트워크가 고정되어 있을 때, 학습해야하는 input-output 쌍을 위상적으로 간단한 형태로 미리 변환(wavelet representation & residual learning)하여 어려운 문제를 쉬운 문제로 바꿔주는 방법을 제안했었고 이 것이 주효하여 3등을 할 수 있었습니다.  

Recursive Learning
Recursive learning은 VDSR과 같이 CVPR 2016에 발표된 Deep Recursive CNN (DRCN)이 최초로 사용한 방식으로 이 역시도 VDSR의 저자인 김지원님이 1저자입니다. 네트워크의 receptive field를 크게 가져가면서도 (increase effective depth) 전체 네트워크의 학습 parameter 수를 줄이기 위해 하나의 모듈을 16번 반복하는 형태를 제안한 것이 특징입니다.

태생적으로 gradient vanishing이나 exploding에 취약하기 때문에 이를 막기 위해 앞서 소개한 residual learning이나 차후 소개할 multi-supervision과 같은 학습 방식과 병행되곤 합니다. 재미있는 점은 반복을 하는 중간 중간의 feature output들을 모두 모아 마지막에 weighted sum(**)을 해서 HR 이미지를 만들어주는데, 이 부분이 특히 성능 향상에 큰 역할을 한 것으로 생각됩니다.
** 여기서 몇가지 아쉬운 점은 각 intermediate feature output의 weight scalar가 학습되는 형태기 때문에 input에 dependent하지 않아서 inference time에 유연성이 좀 떨어진다는 것입니다. 그리고 각 weight가 전체 feature output을 scaling하므로 한 장의 feature map에서 pixel-wise difference가 고려되지 않는다는 점도 개선의 여지가 있겠네요. 

DRCN 이후에도 같은 방식을 차용한 여러 모델들이 제안되었으며, 몇몇 예로는 VGG 형태의 네트워크가 아닌 ResNet을 기반으로 한 Deep Recursive Residual Network (DRRN, CVPR 2017)이나 Memory block을 제안하고 이를 반복하는 MemNet (ICCV 2017) 등이 있겠습니다.

Deeper and Denser Learning
VDSR이 깊은 모델을 성공적으로 학습시켰으나 VGG network 형태는 사실 이렇게 깊은 모델에 적합하지 않다는 것은 잘 알려져 있습니다. 더 나은 성능을 위해 가장 쉽게 해볼 수 있는 방법은 (그리고 잘 알려져있는 성공 공식은) 더 깊은 모델을 사용하는 것이죠. 이런 맥락에서 기본 모델의 골격을 ResNet이나 DenseNet처럼 이미 classification에서 성능이 검증된 모델들로 바꾸는 것이 자연스러운 흐름이었습니다. DenseNet도 ResNet에서 분화한 것이라고 생각한다면, 최근 모델들은 모두 ResNet을 기반으로 하고 있다고 말할 수 있겠습니다.

가장 처음으로 ResNet을 사용한 SR model은 SRResNet (CVPR 2017)으로 같은 논문에서 발표된 SRGAN 모델로 더 유명하기도 합니다. SRResNet은 batch normalization을 사용하기에 깊은 모델을 안정적으로 학습할 수 있었고 좋은 성능을 보였습니다. 비슷한 맥락에서 DenseNet을 사용한 모델으로는 SRDenseNet (ICCV 2017)이나 (연구자들의 naming sense...) Residual DenseNet (RDN, CVPR 2018)등이 있습니다. 어떤 면에서는 앞서 소개한 Recursive learning을 이용하는 모델들은 parameter 증가 없이 effective depth가 깊게 만드는 모델들이라 할 수 있고, DRCN에서 그러하듯 intermediate feature를 뽑아 마지막 단계에서 합치는 것은 dense connection을 주는 것이라 생각할 수 있겠네요.

한편 네트워크를 단순히 깊고 넓게 쌓는 것뿐만 아니라 기존 ResNet 모델을 SISR 문제에 좀 더 적합하도록 개선한 연구가 Enhanced Deep residual learning for SISR (EDSR)입니다. EDSR은 모델의 성능만으로도 매우 뛰어난 연구(**)일뿐만 아니라, 이후 SISR 모델들에 큰 영향을 미친 여러가지 유용한 분석들을 여럿 보여주기 때문에 꼭 알고 넘어가야 할 cornerstone paper 중 하나이므로 좀 자세히 리뷰하도록 하겠습니다.
** 또다시 서울대 이경무 교수님 연구실에서 나온 연구로 CVPR NTIRE 2017년 우승 모델입니다. EDSR의 강력한 점은 모델이 이해하기 쉽고 간단한데, 2017년에 발표된 모델의 성능이 2019년 5월 기준으로도 가장 상위에 속하는 모델들과 비견할만하다는 점입니다 (Table). Set5 dataset에 대한 PSNR과 SSIM을 보더라도 CVPR NTIRE 2018 우승 모델인 DBPN과 비등한 것을 보실 수 있습니다: 
Table 각종 benchmark dataset에 대한 model 성능 비교 [3]


EDSR: EDSR 이전의 모델들은 모두 classification에서 좋은 성능을 보였던 네트워크들(e.g. VGG, ResNet, DenseNet)이 SISR 문제도 잘 풀 것이다라는 가정을 바탕으로 네트워크를 디자인하였습니다. 그러나 잘 생각해보면 high-level abstraction이 중요한 classification과 대표적인 low-level vision 문제인 SISR은 서로 특성이 다릅니다.

 
EDSR의 ResBlock (c)

EDSR은 ResBlock에 붙어있는 batch normalization의 특성상 feature의 정보가 섞이거나 제한된다는 점에 주목하였습니다. Low-level feature를 잘 보존해야한다는 SISR 문제에서는 학습만 안정적으로 가능하다면 batch normalization layer를 제거하는 것이 가장 좋은 성능을 얻을 수 있다는 분석을 제시하였습니다. Batch normalization을 없애면 GPU 메모리 측면에서도 40% 가량 줄어드는 부가적인 이득이 있기 때문에, 지금은 SISR 모델이라면 기본적으로 따르는 프로토콜이 되었을 정도로 널리 사용되고 있습니다.

여기서 한 가지 주의할 점은 "학습만 안정적으로 가능하다면"이라는 전제조건입니다. 얕고 적은 수의 channel을 사용하는 수준이라면 (e.g. ResBlock: 16개, 64ch) 생각보다 학습이 안정적이기 때문에 별다른 처리가 필요없지만, 그 이상으로 깊이 그리고 넓게 쌓을 때는 나눠져서 처리된 feature들이 addition 부분에서 더해지면서 전체 variance가 매우 커지기 때문에 추가적인 처리가 필요해집니다. EDSR에서는 이를 고려하여 깊은 모델에서는 각 block의 마지막 convolution layers 이후에 0.1을 곱해주어(**) 문제를 해결하는데요. 이렇게 heuristic하지만 매우 효과적인 기술(residual scaling)을 바탕으로, 이전까지 존재하던 모델들 중 가장 깊고 넓은 모델을 성공적으로 학습시킬 수 있었습니다.
** 이것은 변수에 scaling이 그 값의 제곱으로 영향이 가는 분산의 성질 (wiki)을 생각하면 이해가 쉽습니다.  

이 외에도 EDSR에서 제안하고 여전히 자주 쓰이는 기법으로는 x2로 학습한 모델을 다른 배율 모델의 시작점으로 사용하는 pre-training이 있습니다. 이렇게 pre-trained model을 사용하면 학습이 가속되고 최종 성능도 올라간다는 것을 보였는데, 이런 결과는 각 배율 별 이미지들이 공유하는 정보가 있다는 점을 알려줍니다. 여기서 착안하여 EDSR에서는 EDSR 구조를 기본으로 하되, multi-scale 이미지를 하나의 모델로 처리하는 것이 가능한 Multi-scale SR network (MDSR)를 추가로 제안하였습니다:

MDSR 구조

그림에서 보실 수 있듯이, 앞과 뒤에 각 배율을 담당하는 작은 모듈들을 두고 중간에 공유하는 네트워크가 있어서 학습시에는 배율에 따라 해당하는 모듈들이 독립적으로 학습되데 공유 모듈은 항상 학습이 되도록 합니다. 이렇게 학습을 하면 단일 배율 모델에 비슷한 성능을 내면서도 하나의 모델로 다양한 배율에 대응이 가능하기 때문에 모델 parameter 측면에서 이득이 생깁니다. (43M$\rightarrow$8M)

SR 결과 비교 (x4 배율)

그림에서 확인하실 수 있듯이 bicubic upsample과는 비교도 안 될 정도로 원본 HR 이미지에 근접한 SR 결과를 보여줍니다.

중간 Summary (~2017)


글이 매우 길어졌기에 여기서 한 번 끊고 넘어가는 것이 좋을 것 같군요. 여기까지가 대략 2017년까지 발전된 SISR 모델들을 모두 정리한 것으로, 개인적으로는 EDSR이 2017년까지의 SISR을 대표하는 모델이라고 생각합니다. EDSR 이후로는 깊은 모델을 학습시키는 방향보다는 다른 형태의 정보를 추가해줄 수 있는 모듈들이 고안하거나 성능을 유지하되 좀 더 가벼운 모델을 만드는 쪽으로 연구의 주안점이 옮겨가기 시작했습니다. 이번 글의 완결성을 위해 network design에서 아직 남은 줄기를 훑으면 아래와 같습니다:

Exploiting Non-local or Attention modules

이제 깊은 모델을 사용하는 것이 SISR 성능 향상에 중요한 역할을 한다는 점은 매우 명확해졌습니다. 그러나 그저 ResBlock을 여러번 쌓는 것만으로는 올릴 수 있는 성능에 한계가 있었습니다. 자연스럽게 좀 더 효과적으로 모델을 학습시킬 수 있는 방법에 관심이 집중되었고 (2019년 기준) 최근에는 LR 이미지의 non-local 정보를 잘 이용하는 연구들이 많이 발표되고 있습니다. 

이런 모델들이 지적하는 기존 모델의 문제점으로는:
  • CNN의 receptive field size가 상대적으로 작다는 점,
  • Feature들이 담고 있는 local 혹은 global 정보가 동등하게 처리된다는 점
등이 있습니다. 더 큰 receptive field size는 더 많은 context 정보를 사용할 수 있도록 도와준다고 생각할 수 있는데, 여기서 context 정보라 함은 반복되는 패턴(e.g., 빌딩의 창문 격자 구조 등)과 같이 global한 정보를 뜻합니다.

이런 context 정보를 local image patch만 사용하여 유추하기는 어렵기 때문에 global한 정보를 얻을 수 있는 방법을 모델에 추가해줄 필요가 있겠죠. 이런 생각을 바탕으로 최근 제안된 모델들은 새로운 convolution (e.g., dilated convolution)이나 (spatial or channel-wise) attention,  다양한 pooling (e.g., pyramid or wavelet) 등을 이용하여 non-local module을 사용합니다.

사실 이렇게 global context 정보를 이용하기 위해 non-local filter를 사용하는 아이디어는 매우 오래전부터 model-based optimization에서 많이 연구되었습니다. 가장 대표적인 예로는 BM3D가 있죠. 최근 Kaiming He가 저자로 참여하고 CVPR 2018에 발표되어 유명했던 Non-local Neural Networks라는 연구에서도 이런 관계를 밝히며, 꼭 SISR에서가 아니더라도 global 정보를 잘 사용하므로써 CNN이 보다 좋은 성능을 낼 수 있다는 사실을 보여주고 있습니다. 
Generative Adversarial Networks in SR

한편 최근 뜨고 있는 모델 형태 중 하나는 generative adversarial network을 사용하는 것입니다. Image Super-resolution은 전통적으로 image "hallucination"이라고 불리기도 하는데요. 이름에서도 알 수 있듯이 없는 것을 만들어낸다는 점을 함의하고 있습니다. 결국 낮은 배율의 이미지가 가진 정보에서 최대한 쥐어짜 이미지를 복원하고 나면, 그 이상으로 할 수 있는 최선은 가장 그럴 듯하게 이미지를 "만들어내는 것"이겠습니다.

이런 맥락에서 인간이 봤을 때 더 그럴듯한 이미지로 SR을 하는 것에 대한 연구들이 진행되고 있습니다. 단순히 PSNR이나 SSIM 같은 hand-crafted metric을 만족시키는 것뿐만이 아니라 perceptual metric을 제안하고 사용하기 시작한 것이죠. SR 분야에서 처음으로 이런 시도를 한 연구는 SRGAN입니다.

다만 아직까지는 perceptual loss가 추가되면 필연적으로 PSNR과 SSIM에서 손해를 보기에 전통적인 competetion에서 이런 모델들이 두각을 보이진 못하고 있습니다. 그러나 ECCV 2018에서 SR 최초로 perceptual metric을 competition에 사용하면서 앞으로는 연구 관심이 더 확대될 것으로 기대됩니다.

관련 논문들: 
"Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network" (SRGAN, CVPR 2017)
"A fully progressive approach to single-image super-resolution", (ProSR, CVPR NTIRE 2018)
"ESRGAN: Enhanced Super-Resolution Generative Adversarial Networks" ECCV 2018
"2018 PIRM Challenge on Perceptual Image Super-resolution", (ECCV 2018)

맺음말


여기까지가 2018년부터 2019년 CVPR 전까지 발표된 SISR 연구 흐름이라 생각됩니다. 아마 곧 있을 CVPR 2019에서 더 많은 논문들이 발표되겠죠. 다음 글에서는 위에 간략히 살펴본 내용과 더불어서 CVPR 2019에서 발표된 연구들까지 포함하는 것으로 network design에 대한 내용을 마무리 짓고 learning strategy 측면의 발전과 여전히 남은 한계점들에 대한 내용을 다룰 예정입니다. 그러면 이번 글은 여기서 마무리 하겠습니다. 다음 글에서 뵙지요.

참고 자료 


[1] Deep Learning for Image Super-resolution: A Survey Wang et al. 2019
[2] Deep Learning for Single Image Super-Resolution: A Brief Review Yang et al. 2018
[3] A Deep Journey into Super-resolution: A Survey Anwar et al. 2019


다음 읽을 거리


2019년 5월 14일 화요일

Image Restoration (IR): inverse problem point of view (2)

이전 글에서 전통적인 model-based optimization 방식에 대해 알아보았다면, 이번 글에서는 deep learning이 이런 관점에서 어떻게 해석될 수 있는지 알아보고자 합니다.

Model-based vs. Deep Learning-based


Bayesian 관점에서 보면 Image Restoration (IR)에서 풀고자 하는 문제를 아래와 같이 Maximum A Posteriori (MAP) 형태로 표현할 수 있다고 말씀드렸었습니다: $$\begin{align} \hat{x} &=\arg\min_x\{-\log P(y|x)-\log P(x)\} \notag\\ &= \arg\min_x\{\frac{1}{2\sigma^2}||y-Hx||^2_2+\lambda\rho(x)\}\end{align}$$ 이 문제를 푸는 방식은 model-based optimization과 discriminative learning 이렇게 두 가지로 방식으로 나눌 수 있다고 말씀드렸었죠. 지난 글에서 소개했던 model-based optimization은 image degradation($H$)을 정하고, 특정 image prior(e.g., sparsity, low-rank, etc.)를 고안하여 그렇게 만들어진 모델(objective function)의 최적해를 구하는 것으로 IR 문제를 해결하고자 합니다.

한편, discriminative learning에 속하는 방식들은 여러 장의 손상된 이미지와 원본 이미지 쌍으로 이루어진 학습 데이터로부터 일종의 mapping function을 학습하고자 합니다. Discriminative learning에서의 IR 모델은 일반적으로 $$\min_\theta l(\hat{x},x),~\text{s.t}~\hat{x}=\mathcal{F}(y,H;\theta)$$와 같으며, 여기서 $\mathcal{F}(\cdot)$은 parameter set $\theta$로 표현되는 mapping function, $l(\hat{x},x)$는 resolve된 이미지와 원본 이미지 간의 유사도를 측정하는 loss function입니다. Deep learning에서는 보통 CNN이 inference (mapping) function 역할을 하게 됩니다.

Deep learning for IR


IR 분야에 deep learning을 적용한 가장 초기의 연구는 single-image super-resolution (SISR) 문제를 푼 SRCNN으로, 두 개 layer로 이루어져 있는 초보적인 형태를 갖고 있습니다. 그럼에도 불구하고 기존의 방식들 대비 매우 강력한 성능을 보여주었으며, 단순히 CNN을 사용하여 성능 개선을 꾀한 것뿐만 아니라 CNN 모델의 sparse coding과의 연관성에 대한 분석으로 서로 다른 두 영역의 가교 역할을 해준 중요한 연구였습니다.

이후 진정 deep learning이라고 할 수 있는 깊은 구조를 사용한 모델들은 서울대 이경무 교수님 연구실에서 나온 VDSR이 시초이며, 지금은 매우 많은 연구들이 폭발적으로 진행되고 있습니다 (**). 다만 CNN을 사용한 image restoration 연구들은 이 짧은 글 하나로 담기에는 너무 방대하고 이 글의 목적인 개괄적인 소개와는 거리가 있기에 다른 글로 소개하겠습니다 (**).
** 그 중에는 제 논문도 있지요!ㅎㅎ CVPRW NTIRE 2017 3rd winning model (paper)
** IR 중에서 super-resoltion에 국한한 연구들을 모아 따로 Survey 글을 작성 했으며 이로써 갈음하고자 합니다. 

각 방식의 장단점을 따져보면, model-based optimization은 여러가지 degradation에 대해 사용자가 유연하게 forward 모델을 만들어 사용될 수 있습니다. 즉, image prior가 주어지면 $H$만 바꿔가며 같은 알고리즘으로 여러 IR 문제들을 풀 수 있습니다. 단점은 각 instance마다 새로운 optimization 문제를 풀어줘야하기 때문에 느리겠죠.

반면에 CNN을 이용한 discriminative learning-based 방식은 그 특성상 parametric mapping function $\mathcal{F}_\theta(\cdot)$이 학습 데이터와 매우 강하게 엮여 있습니다. 때문에 Image prior 자체를 데이터로부터 배우면서 좀 더 강력한 representation이 가능하므로 더 좋은 성능을 보이며, optimization에 드는 cost를 training phase로 넘길 수 있고 test phase에서의 inference가 빠릅니다. 그러나 데이터에 의존적인 면이 있으며 하나의 degradation에 대해서만 적용이 가능하고 따라서 모델의 유연성이 떨어진다는 단점이 있습니다.

이를 정리하면 아래 표와 같습니다:

Model-based optimization methodsDeep CNN-based methods
ProsGeneral to handle different IR problems
Clear physical meanings
Data-driven end-to-end learning
Efficient inference during test-phase
ConsHand-crafted priors (weak representations)
Optimization task is time-consuming
Generality of model is limited
Interpretability of model is limited

Deep image prior


Deep learning도 결국에 일종의 learnable image prior 혹은 image model $P(x)$를 배운다는 점에서 model-based optimization 방식들과 연관이 있다고 생각할 수 있습니다. 그러나 결국에 문제를 푸는 방식에 있어 서로가 매우 다른 전략을 취하기에 그 이상으로 연관짓기란 쉽지 않죠.

그런 면에서 deep image prior (CVPR 2018)는 서로 매우 달라보이는 두 방향의 연구(model-based optimization vs. deep learning)들을 이어주는 멋진 연구입니다. 제가 개인적으로 매우 좋아하는 논문이기도 합니다.

DIP가 멋진 이유는 기존의 inverse problem의 regularization 방식을 다루는 새로운 시각을 보여줬기 때문입니다. 대다수의 deep supervised learning 방식들과 달리 "네트워크 구조 그 자체"를 inverse problem의 regularizer로 사용하는 신선한 방법을 제안하는 데요.

좀 더 구체적으로 표현하자면, CNN의 구조 자체가 매우 강력한 (내재적인) prior라서 CNN이 표현 가능한 parametric function space가 일반적이지 않다는 가정에서 출발합니다. 이를 바탕으로 DIP는 우리가 모르는 latent image $x$를 CNN output으로 놓되 $z$라는 고정된 random vector에 대해서 아래와 같은 objective function에 대한 optimization 문제를 풉니다: $$\min_\theta ||H\mathcal{F}_\theta(z)-y||_2^2,\qquad \text{where }x=\mathcal{F}_\theta(z)$$ 예를 들면, 어떤 noise가 더해진 이미지를 주고 CNN을 사용하여 이런 이미지를 아무리 fitting (regression or generation)하려 해도 (GAN에서 generator를 생각하시면 편합니다), 해당 CNN으로 대표되는 parametic function space의 함수들로는 성질(property)이 좋지 않은 noise를 표현할 수가 없기에 natural image만을 fitting하여 깨끗한 결과를 내보낸다는 것이죠.

재미있는 점은 이제 CNN이 이미지 한 장 한 장에 대해 optimization 문제를 풀어 $\theta$를 구한다는 것입니다. 마치 model-based optimization 방식들 같죠? 따라서 다른 model-based optimization이 그러하듯 DIP도 unsupervised 방식으로 IR 문제를 풀 수 있게 됩니다.

DIP는 이를 super-resolution 뿐만 아니라 denoising, JPEG deblocking, inpainting 등 여러 IR 문제에 적용(model-based optimization의 유연성) 가능한 framework을 제안하면서도 기존의 optimization 방식들보다 월등한 성능(deep learning의 성능)을 보여주었습니다.


Inpainting과 denoising task


Blind restoration of a JPEG-compressed image


4x image super-resolution

Deep Plug-and-Play Priors 


앞서 소개한 DIP는 학습되지 않은 네트워크를 사용해서 멋진 결과들을 보여주었는데, 혹시 그러면 기존에 이미 IR에 대해 학습이 잘 된 deep model들을 가져와서 plug-and-play 방식으로 사용하여 좀 더 강력한 IR 모델을 만들 수는 없을까요?

이런 방향의 연구 역시 매우 흥미로운 주제이고, 최근 들어 다양한 방향으로 개발이 되고 있습니다. 이 부분은 제가 알고 있는 최신 연구들만 해도 네다섯 개가 넘는 논문들이 있기 때문에, 이에 대한 리뷰는 아무래도 기회가 된다면 다른 글에서 소개해야 할 것 같습니다.

맺음말


이로써 Image restoration 문제를 푸는 두 가지 대표적인 방식에 대해 살펴보았고, 전통적으로 IR 문제를 풀던 model-based optimization의 관점에서 새로 떠오르고 있는 deep learning-based 방법들이 어떻게 해석될 수 있는지까지 확인해보았습니다. 

이 글에 나오는 해석은 제가 개인적으로 공부하며 제 생각과 함께 정리한 것이기 때문에 꼭 절대적으로 맞는 방향이라고 할 수는 없으나, 전체적으로는 다른 유수의 연구자들이 공감하는 방향일 것이라 생각합니다. 

"기존의 모델들과 deep learning 방식의 모델 사이의 관계를 밝히고, 이로부터 얻은 insight를 바탕으로 새로운 아이디어를 제안하는 연구"가 제가 생각하는 이상적인 연구인데요. 아직은 내공이 부족하여 쉽지는 않겠지만 거북이처럼 천천히 가더라도 끝까지 계속 공부하는 연구자가 되고싶습니다. 

다음 읽을 거리


2019년 5월 13일 월요일

카카오 리포트 (Part II)

지난 글에서 GAN의 기본 원리와 배경 이론에 대해 살펴보았다면, 이번 글에서는 GAN에 대한 기본적인 이해를 바탕으로 GAN의 특징과 장단점에 대해 조금 더 심화된 내용을 다루고자 한다. 

DCGAN


초창기 GAN에 대해 얘기하려고 하면 빼놓을 수 없는 연구가 바로 DCGAN이다. GAN이 지금은 매우 뛰어난 결과들을 보여주고 있지만, 초기 결과는 아이디어의 참신성에 비해 그리 인상적이지 않았다. GAN 구조가 학습시키기 매우 어려웠다는 것도 여러 이유 중 하나였는데 Deep Convolutional GAN (DCGAN)이 나온 이후, GAN으로 만드는 결과들이 매우 급격하게 발전하기 시작했다. 크게 이 논문이 기여한 바를 정리해보면,

  • 대부분의 상황에서 언제나 안정적으로 학습이 되는 구조를 제안하였다는 점
  • 마치 word2vec과 같이 DCGAN으로 학습된 생성기가 벡터 산술 연산이 가능한 성질을 갖고 이것으로 의미론적(semantic)으로 신규 샘플을 생성할 수 있다는 것을 보여주었다는 점

등이 있겠다. 

DCGAN 논문은 GAN이 잘 학습되는 구조를 매우 세세한 가이드라인으로 제시한 연구이다. 이 논문 이후에 나온 대부분의 GAN 연구들은 어떤 형태로든 DCGAN 구조를 바탕으로 하고 있다고 할 정도로 매우 잘 확립된 구조이다. 일단 DCGAN에서 제시한 가이드 라인대로 GAN 구조를 짜면 상당히 안정적으로 학습이 된다. 이런 구조를 발견하기 위해서 얼마나 대학원생들이 힘들었을지 논문의 한 구절에서 언뜻 느껴볼 수 있다. 

“However, after extensive model exploration, we identified a family of architectures that resulted in stable training across a range of datasets and allowed for higher resolution and deeper generative models.”

DCGAN은 이름에서 알 수 있듯이 convolution 구조를 GAN에 잘 결합한 것이다. Convolutional neural network (CNN)이 지도학습(supervised learning)에서 매우 큰 성공을 거둔 것에 비해 비지도 학습(unsupervised learning)에서는 상대적으로 잘 사용되지 못하였다. 그런 면에서 DCGAN 논문은 지도학습에서 CNN의 성공적인 모습과 비지도 학습에서의 격차를 줄이는 데에 큰 역할을 하였다고도 평가된다. 그러나 이렇게 추상적인 영향력을 굳이 말할 필요가 없을 정도로 생성한 이미지의 질부터 매우 인상적인 것을 볼 수 있다. 

DCGAN 결과에서 가장 재미있는 부분은 아래와 같이 생성기의 입력으로 들어가는 $z$ 은닉 공간(latent space)에서 벡터 산술 연산이 가능하다는 점이다. 가장 흔한 예시로 word2vec 연구가 있다. 다음 수식을 계산하고 답을 추정해보자: $$KING~(왕) - MAN~(남자) + WOMAN~(여자)$$
사람은 생각보다 쉽게 
$$QUEEN~(여왕)$$
이라는 단어를 연상할 수 있지만 컴퓨터에게 이런 연산은 사실 

  1. 단어의 의미를 이해하고,
  2. 그에 맞는 새로운 단어를 찾는 등의

매우 고차원의 처리가 필요한 어려운 문제이다. 기존의 word2vec 연구에서는 뉴럴넷을 사용하여 말뭉치에서 실제로 단어 간의 관계를 학습하는 것을 보여주었고, DCGAN은 이런 문제를 말뭉치가 아닌 이미지에서 하는 것이 가능하다는 것을 보여주었다. 아래 그림이 바로 그 결과이다.


실제로 모두 DCGAN으로 생성된 결과들이다. 상당히 진짜 같은 결과만으로도 놀라운데, 이미지가 갖는 의미를 바탕으로 직관적인 벡터 산술이 된다는 것을 알 수 있다. 안경을 쓴 남자와 그냥 남자 그리고 일반 여자를 생성하게 하는 입력값들이 은닉 공간에 각각 벡터로 존재하고 있을텐데, 각각의 벡터를 서로 빼고 더해주면 최종적으로는 안경을 쓴 여자를 생성하는 입력 벡터를 찾을 수 있다는 것이다. 

물론 생성기의 입력인 $z$ 벡터 하나만으로는 깔끔한 결과가 나오지 않기에 세 개 정도를 평균한 $\bar{z}$ 벡터를 사용해서 결과를 만든 것이기는 하지만 신기한 것은 매한가지다. 어떻게 보면 네트워크가 영상의 의미를 이해했다고 생각할 수 있다. 

이 외에도 아래와 같이 침실을 생성한 결과 그림들을 보면 작은 그림이긴 하지만 꽤나 그럴듯한 결과를 만들어 냈다는 것을 확인할 수 있다. 
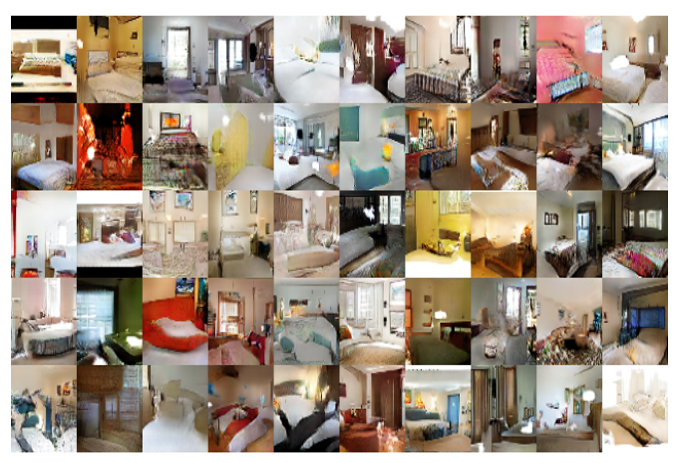
다섯 번 epoch을 돌려 학습한 후 생성된 침실 사진

뿐만 아니라 논문에서 "공간을 걷는다"라고 표현하였듯이 은닉 공간에서 천천히 벡터의 값을 바꿔가면, 생성기가 내보내는 이미지가 하나의 침실에서 다른 침실로 위화감 없이 부드럽게 변화하는 것을 볼 수 있다. 특히 벽이었던 부분이 자연스럽게 하나의 창으로 변화해가는 것을 보면 매우 놀랍다. 

"은닉 공간에서 돌아다니기"

만약 생성기가 단순하게 영상을 외워서 보여줄 뿐이라면 주어진 특정 입력에 대해 특정 이미지를 내보내는 일대일 대응 함수를 학습한 것으로 생각할 수 있다. 이럴 경우 은닉 공간에서 굳이 부드러운 변화가 있을 이유가 없다. 바로 옆의 $z$ 벡터가 전혀 다른 샘플과 일대일로 연동될 수 있기 때문이다. 이렇듯 은닉 공간에서 벡터 연산이 가능하다는 것과 입력에 변화를 줬을 때 생성되는 결과가 부드럽게 변하는 것을 보는 등의 분석이 중요한 이유는 우리가 학습시킨 GAN의 생성기가 일대일 대응 함수와 같이 매우 단순한 의미없는 함수(mapping)를 학습한 것이 아니란 것을 시사하기 때문이다. 

이렇게 수많은 이미지를 표현할 수 있는 정보들을 포괄할 수 있으면서도 부드러운 변화에 대응할 수 있는 함수를 학습할 수 있게 하기 위해서 은닉 공간을 잘 정하는 것도 매우 중요한 일이다. GAN에서는 보통 $z$ 은닉 공간은 고차원의 가우시안 분포를 많이 사용한다. 적절한 가정 하에서 충분히 복잡한 함수를 사용하여 대응시킬 수만 있다면 임의의 $d$ 차원 분포는 정규 분포를 따르는 $d$개의 변수로 나타낼 수 있다는 것이 알려져 있기 때문이다. 

기존 생성 모델과 GAN의 차이점


그러면 GAN은 기존의 생성 모델들과 어떤 면이 다르기에 이렇게 비교적 또렷한 이미지를 만들 수 있는 것일까? GAN의 특징이자 가장 큰 차이점은 바로 GAN이 사실 샘플러(sampler)라는 것이다.  즉, 직접적으로 데이터의 분포를 학습하는 형태가 아니라 하나의 입력이 들어갔을 때 하나의 출력을 주는 형태의 독특한 특징을 지닌다.

조금 더 자세히 이해하기 위해 "확률 모델을 학습한다"는 것에 대해 생각해보면,


모델을 추정한다는 것은 일반적으로 우리가 알고 싶은 $\cal{P}$라는 진짜 데이터의 분포가 어딘가에 있을 때, 이로부터 얻은 샘플들이 i.i.d.하게 관측되었다고 가정한 후 $\cal{Q}$라는 모수 모델 클래스(parametric model class)를 만들어 그 안에서 $\cal{P}$와 가장 "가까운" 모델의 모수를 찾아내는 것을 말한다. 가장 간단한 예시로 데이터의 분포가 정규 분포를 따를 것이라 가정하여 가우시안 모델을 세우고 현재 내가 갖고 있는 데이터를 가장 잘 설명할 수 있는 평균과 분산 값을 찾는 과정을 생각해볼 수 있다.

이를 위해서는 $\cal{P}$와 $\cal{Q}$의 "차이" 혹은 "거리"를 계산할 수 있어야 한다. 그러면 구한 두 분포 사이의 거리를 줄여나가는 방향으로 모델의 모수들을 조정할 수 있고, 이 과정을 적합(fitting)이라고 한다. GAN도 Jensen-Shannon divergence라는 측도를 사용하여 분포 간의 거리를 계산하고 이를 최소화하는 방향으로 생성기를 학습한다고 분석할 수 있다. 

보통 기존의 방식에서는 아래와 같은 $\cal{Q}$에 대한 가정들을 사용하는데:
  • tractable sampling
  • tractable parameter gradient with respect to sample
  • tractable likelihood function

이 중 가장 강력한 가정이 바로 우도 함수(likelihood function)가 계산 가능하다(tractable)는 것이다. 많은 경우 현실의 모델은 계산이 불가능한 형태의 수식으로 나타나는 것을 상기한다면 기존의 모델들이 얼마나 강력한 가정을 사용하고 있는지 알 수 있다. 

한편 GAN 형태의 모델들은 임의의 확률 변수 입력 값을 사용하여 비선형 변환 함수를 통과시키면 출력으로 샘플이 하나 튀어나오는 구조이다. 마치 버튼을 누르면 샘플이 튀어나오는 자판기처럼 생각할 수 있다. GAN 모델들의 독특한 점은 바로 이 부분에서 나온다. GAN 모델들은 다른 확률 모델들과는 달리 우도 함수를 근사하려하지 않고 샘플을 뽑아주는 함수를 학습했을뿐이기 때문에 우도 함수 모델링이 필요없는(likelihood-free) 모델이라고 할 수 있기 때문이다. 

물론 이 부분은 GAN의 특징일뿐 장점일 수도 있고 단점이라 할 수도 있다. 데이터 분포에 대한 모델을 특정하지 않고 하나의 샘플을 뽑아서 보여주기 때문에 고정된 모델에 한계에 제약을 받지 않고 또렷한 이미지를 보여줄 수 있기도 하지만, 다른 한편으로는 정작 이미지를 잘 뽑더라도 데이터의 분포에 대한 정보를 직접적으로 얻기는 어렵기 때문에 분포를 알았을 때 시도해볼 수 있는 많은 분석들을 시도할 수가 없다는 아쉬움이 있다. 이 부분에 대해서는 Ian Goodfellow의 NIPS 2016 tutorial 논문[ref]이나 같은 워크샵에서 발표된 Sebastian Nowozin의 f-GAN [ref] 논문을 참고한다면 조금 더 심화된 내용을 확인할 수 있다.

이외에도 이후 연구된 WGAN에서는 기존의 GAN이 divergence를 측도로 사용하기 때문에 생기는 여러가지 문제를 지적하며 다른 방식의 측도를 제안하는 등, 점차 수식적인 분석과 함께 GAN의 가치 함수 자체를 근본적으로 수정하는 방향으로 연구가 발전되었다. 이를 바탕으로 보다 안정적인 학습과 결과를 보여주었는데 EBGAN LSGAN BEGAN 등 이후 나온 많은 GAN들이 WGAN의 카테고리로 분류할 수 있다.

이렇게 보면 모든 연구가 끝나서 더이상 할 것이 없는 것처럼 보이고 점차 이론적인 문제로 깊게 들어가면서 수학이 많이 들어가고 공학자들이 개입할 수 있는 여지가 없는 것 같지만 아직은 직관이 필요한 부분들이 많이 남아있으며 풀어야할 문제들도 많이 남아있다. 

학습이 예전에 비해 수월해졌다는 것이지 정말 쉬워졌다는 것을 의미하진 않고 네트워크의 안정적으로 학습이 이미지의 질을 보장하지 않는 경우가 많으며 수렴은 여전히 어렵고 이어 소개할 mode collapse나 모델 평가 등 역시 아직도 풀어야 할 문제가 산적해 있다. 그런 의미에서 GAN 학습이 어려운 이유를 하나씩 소개하겠다. 

GAN 학습이 어려운 이유 I: Convergence


지난 글에서 소개하였듯이 원 논문에서 GAN에 대한 이론적 근거를 증명해주었지만 아쉽게도 실제 구현은 이론적 배경이 되는 가정과 거리가 있다. 때문에 GAN 가치 함수를 뉴럴넷을 이용하여 풀었을 때 이상적인 전역해로 수렴한다는 보장이 되지 않는다. 게다가 풀어야하는 문제의 형태부터 이미 쉽게 문제를 풀 수 있는 볼록 함수 형태가 아닌 변수 두 개가 서로 엮여있는 안장점 문제(saddle point problem)를 고려해야하기 때문에 GAN은 학습이 매우 어렵기로 유명하다. 

이 때문에 많은 사람들이 생각보다 간단한 예제에서도 문제를 풀기가 어려울 수 있는데 더 복잡한 문제에서 GAN 형태가 잘 풀릴 것인지에 대해 의문을 제기한 바 있다. 이 문제를 약간 더 직접적으로 느끼기 위해서 실제로 간단한 예제인 $V(x,y) = xy$가 어떻게 생겼는지 그려보면 다음과 같다. 
f(x,y) = xy

이 문제는 $x=0, y=0$에서 안장점을 갖는 매우 대표적인 예시다. 그리고 $x$와 $y$에 대해 최소최대 문제를 풀면 이 안장점이 평형점이라는 것도 쉽게 알 수 있다. 사실 안장점이 모두 평형점이 되는 것은 아니지만 이 경우 하나의 변수에 대한 작은 변화가 다른 변수에 대해 가치 값을 줄일 수 없기 때문에 평형점이 되는 것이다. 만약 이 문제를 구배 감소법(gradient descent)으로 풀면 결과가 평형점 주변에서 수렴하지 못하고 최초 시작점에 따라서 반지름이 정해지는 궤도(orbit)를 영원히 움직이는 것을 확인할 수 있다. 심지어 학습율(learning rate)이 크면, 바깥 방향으로 발산하는 경우도 생길 수 있다. 

이를 수식과 함께 확인해보면 좀 더 명확해진다. 학습율 $\gamma$를 고정하고 $n\in\mathbb{N}$일 때, 각 변수에 대해 구배 감소를 번갈아 계산하는 것은
$$\begin{align*} &x_{n+1} = x_n-\gamma y_n \\&y_{n+1}= y_n+\gamma x_n\end{align*}$$
와 같이 나타낼 수 있다. 이 때,
$$\left[ {\begin{array}{c}
x_{n+1} \\
y_{n+1} \\
\end{array} }\right] = \left[ {\begin{array}{cc}

1 & -\gamma \\

\gamma & 1 \\

\end{array} }\right] \left[{\begin{array}{c}

x_n \\

y_n \\

\end{array} }\right]$$
이므로 여기서 $$\left[{\begin{array}{cc}
1 & -\gamma \\
\gamma & 1 \\
\end{array} }\right] = \frac{1}{\alpha}\left[ {\begin{array}{cc}
\alpha & -\alpha\gamma \\
\alpha\gamma & \alpha \\
\end{array} }\right] = \frac{1}{\alpha}\left[{\begin{array}{cc}
\cos\theta & -\sin\theta \\
\sin\theta & \cos\theta \\
\end{array} }\right] $$
로 바꾸고 $\alpha = \sqrt{\frac{1}{1+\gamma^2}}\in(0,1), \theta = \cos^{-1}\alpha\in\left(0,\frac{\pi}{2}\right)$이라 해보겠다. 고등학교에서 회전 행렬에 대해 배운 사람이라면 위의 행렬식이 매우 익숙할 것이다.  $\gamma\approx0$일 때, 즉 학습율이 충분히 작아서 $\alpha\approx 1$이면 구배 감소의 결과가 언제나 안정한 궤도(stable orbit)으로 빠지고, $\alpha<1$인 경우 $(x_n,y_n)$이 나선형으로 발산하게 된다. 

GAN 학습이 어려운 이유 II: Mode Collapse


앞서 소개한 문제도 그렇지만 GAN 학습이 어려운 이유는 대부분 그 가치 함수의 형태에서 기인한다. 두 번째로 소개할 mode collapse 문제 역시도 GAN의 독특한 가치 함수와 그 문제 풀이 방식 때문에 생기는 것으로 해석할 수 있다. 
Mode Collpase 예시 [ref]

위 그림이 전형적인 mode collapse 문제의 예시다. 맨 오른쪽의 목표 분포를 보시면 가우시안 혼합 모델로 총 여덟 개의 최빈값(mode)이 있는 것을 볼 수 있다. 아래 줄의 그림이 이 목표 분포를 근사하기 위해 GAN으로 여러번 반복하여 학습을 한 결과들을 보여준다. 

GAN이 뽑은 샘플들을 보면 각각의 최빈값들을 각 단계마다 돌아가며 방문하는 것을 볼 수 있다. 즉, 원래라면 윗 줄과 같이 전체 최빈값들을 보고 목표 분포가 여덟 개의 최빈값을 갖는 분포라는 것을 찾아내야하지만, GAN은 그렇게 하지 못하는 모습을 보여준다. 좀 더 직접적인 예를 들자면 숫자가 1부터 8까지 섞여 있는 이미지들로 데이터 분포가 있을 때, 우리는 GAN이 1부터 8까지 모든 숫자들을 만들어낼 수 있기를 바라는데 실제로는 1과 같이 가장 쉬운 한 가지 숫자만 만드는 모델을 학습한다는 것이다. 이런 현상을 하나의 최빈값에만 함몰되는 모델이나 함수를 학습한다고 하여 mode collapse 문제라고 부른다. 

사실 우리가 매 단계마다 최적의 구별자 $D^*$를 계산할 수 있다면야 이런 문제가 생기지 않겠지만 뉴럴넷으로 모델을 만들 경우 수렴이 될 때까지 계산을 매우 여러 번 해야하고 여러 가정이 깨지면서 수렴이 보장되지도 않는다. 따라서 현실적으로는 가치 함수를 각각의 변수에 대해 일정 횟수만큼 번갈아 푸는 방식을 택하는데 이런 방식 때문에 문제가 생기게 된다. 

원래 풀고자하는 GAN의 가치 문제는 다음과 같은 최소최대 문제이다:
$$G^* = \min_G \max_D V(G,D).$$
그렇지만 실제 학습을 할 때는 $G$와 $D$에 대해 번갈아가며 풀어주기 때문에 뉴럴넷의 입장에서는 이러한 최소최대 문제와 아래 같은 최대최소 문제가 구별되지 않는다:
$$G^* = \max_D \min_G V(G,D).$$
문제는 최대최소 문제에서 생긴다. 수식의 안 쪽부터 살펴보면 $G$에 대한 최소 문제가 먼저 있기 때문에 생성자의 입장에서는 현재 고정되어있는 (비최적, non-optimal) 구별자가 가장 헷갈려 할 수 있는 샘플 하나만 학습하면 된다. 즉, 가치 함수를 가장 최소화할 수 있는 최빈값 하나만 내보내면 된다. 이렇듯 GAN의 가치 함수 자체와 엮여 있는 문제이기 때문에 mode collapse 문제는 아직도 GAN에서 완전히 해결되지 않고 있다. 

GAN 학습이 어려운 이유 III: Evaluation


이에 더해 모든 생성 모델이 갖는 고질적인 문제가 파로 평가의 객관성이다. 생성을 한 이미지의 질을 평가할 수 있는 객관적인 기준을 정하는 것이 매우 어렵기 때문에 새로운 모델이 예전의 모델에 비해 발전한 것인지 평가하는 것이 쉽지 않고 연구의 방향을 잡기도 어렵다.

현재 사용되는 방식을 몇 가지 살펴보자면 대표적인 것이 아마존 매카니컬 터크(Amazon Mechanical Turk)를 사용하여 사람이 직접 평가하도록 하는 방식이다. 그러나 이런 방법은 매우 주관적이고, 일관된 평가가 어려우며, 위에서 설명한 mode collapse가 일어난 경우 전혀 모델의 문제점을 파악할 수 없다는 단점이 있다. Mode collapse가 일어난 모델의 경우 생성하는 이미지의 다양성이 부족할 뿐이지 단일 이미지의 자체는 상당히 질이 좋을 수 있기 때문이다.

두번째로는 Inception score라고 하여 구글의 인셉션 이미지 분류 모델에 생성된 이미지를 넣어 나오는 값을 바탕으로 평가를 하는 방식이 있다. 이 방법은 값이 일관되고 어느 정도 객관성을 보장할 수 있다는 장점이 있어 꽤 자주 사용되고 있다. 하지만 굳이 인셉션 모델을 사용해야하는 이유도 없고 어떤 모델의 경우 인셉션 모델에 특화(overfitting)되어 실제 이미지의 질과는 무관하게 점수가 좋게 나올 수도 있다는 문제를 안고 있다.

이렇게 앞서 소개한 문제들 외에도 다양한 연구거리가 남아있겠지만 세 가지로 크게 정리해보았다. GAN 연구가 활발하고 매일 하루가 멀다하고 쏟아지는만큼 더이상 연구할 것이 없고 너무 늦었다고 생각할 수 있으나 알고보면 아직 가야할 길이 멀다.

창GAN기-믿거나 말거나


마지막으로 GAN에 대한 탄생비화 [ref]를 소개해드리면서 글을 마무리하겠다. Ian Goodfellow가 최초로 만든 GAN은 multi-layer perceptron (MLP)을 이용한 매우 단순한 형태의 GAN이었다고 한다. 거짓말 같지만 단 한 번의 시도만에 바로 성공했다는데... 물론 매우 간단한 문제에 대해 적용해봤을 것으로 추측되지만 GAN이 수렴시키기 어렵기로 악명 높다는 것을 생각해보면 솔직히 믿기지 않는 일화이다 (마치 박혁거세 설화를 보는 느낌이랄까...). 

Ian Goodfellow가 GAN에 대한 아이디어를 처음 떠올린 순간은 몬트리올의 ``The 3 Brewers''라는 펍에서 친구들과 얘기를 하던 중이었다고 한다. 박사를 마치고 연구실을 떠나는 친구를 송별하는 자리였는데, 그렇게 모인 친구들 중 한 명이 모든 사진의 통계적 정보를 넣어서 스스로 사진을 만들어 낼 수 있는 기계에 대해 얘기를 꺼냈고, 어떻게 하면 그런 기계를 현실적으로 만들 수 있을 지에 대해 논쟁이 벌어졌다. 

존재하는 모든 사진에 대한 통계적인 정보를 얻는 것부터 일단 말이 되지 않으니 불가능한 프로젝트라고 생각하다가 순간 뉴럴넷을 사용해서 기계를 가르치면 더 진짜 같은 사진을 만들 수 있지 않을까 하는 생각이 들었다고 한다. 하지만 친구들은 그 아이디어에 대해 부정적이였고, 살짝 열이 받은 Ian은 새벽에 술자리에서 돌아오자마자 앉은 자리에서 노트북으로 GAN을 코딩했다고 한다. 그리고 거짓말 같이 단 번에 성공했다는데, 이후 인터뷰에서도 ``매우 매우 운이 좋았다. 만약 GAN이 한 번에 성공하지 않았다면, 그냥 포기했을 것이다'' 라며 스스로도 운이 좋았다고 하였다. 

이 인터뷰 내용이 사실이라면 여기서 우리는 여러가지 교훈을 얻을 수 있다 (옛날 이야기에는 언제나 교훈이 있는 법). 문제를 설정하고 풀 때 직관력이 매우 중요하다는 것과 그 직관으로 얻은 아이디어를 바로 실험해보는 실행력이 중요하다는 것, 술자리에서 연구 얘기만 주구장창 하여도 진지하고 재미있게 들어줄 사람들이 있는 집단에 들어가야 한다는 것 그리고 마지막으로 되는 놈은 뭘 해도 된다고 운도 조금은 좋아야 한다는 것이다. 희망적인 것은 어떤 문제에 대한 직관력은 그 분야와 연관된 깊은 수학적 지식에서 나올 수도 있지만 수많은 시행착오(a.k.a. 삽질)을 바탕으로 한 경험으로 길러질 수도 있다는 점이다. 그리고 매우 다양하게 많은 시도를 하다보면 통계적으로 되는 방법을 찾을 확률이 높으니 운이라는 것도 어느 정도 통계에 기대볼 수 있을 것 같다. 이렇게 열정적으로 문제를 풀다보면 비슷한 사람들이 모여있는 집단(카카오..?)에 갈 수 있는 기회가 생기고, 더 재미있게 잘 연구를 할 수 있는 선순환이 이루어지지 않을까? 

엄밀한 수학 지식을 바탕으로 차근차근 쌓아 올렸을 것 같은 매우 복잡한 이론들도 순간적인 직관에서 시작하는 경우가 매우 많은 것 같다. 그러니 수학이 어려운 공학자들이여 우리 모두 힘을 내자! 수학을 잘하는 수학자들과 실험을 바탕으로 감이 살아있는 공학자들이 각자가 잘하는 영역에서 연구를 하며 협업을 통해 문제를 발전시켜 나간다면 언젠가는 정말로 이미지뿐만 아니라 사람의 생각을 모사하는 궁극의 생성 모델을 만들 수 있지 않을까 기대해본다.

다음 읽을 거리


카카오 리포트 (Part I)

이전에 카카오 리포트에 기고한 글을 개인 블로그에도 올린다. 두 파트로 나뉘어 글을 기고하였는데, 둘이 합쳐 GAN에 대한 전체적인 조망이 되기 때문에, 개별 GAN 논문을 리뷰하는 것에 비해 개괄적인 정보를 알 수 있을 것이다.

파트 I은 GAN에 대한 소개로 이전 초짜 대학원생 시리즈에서 대부분 다룬 내용이지만 첫 글 이후로 GAN에 대해 이해가 더 깊어진 후 정리한 글이기에 내용적 측면에서 낫다는 장점도 있겠다. 파트 II는 GAN 연구에 대해 좀 더 개괄적으로 다루고 있으므로 연구 방향이나 흐름을 빠르게 알고 싶은 사람들에게 도움이 되리라 생각한다.

** 이 글을 기고할 당시만 해도 대학원생으로 박사 졸업을 언제 할 수 있을지 불분명 하였을뿐 아니라, GAN이 참 재미있으면서도 내 연구 주제에 머신러닝을 적용하는 것이 가능할지도 잘 모르던 때였는데, 지금은 네이버에서 본격적으로 generative model들을 연구하고 있으니 시간이 참 빠르다. 열심히 살아야지. 
2019.05.13


2019년 5월 12일 일요일

Image Restoration (IR): inverse problem point of view (1)

제 박사 학위 논문 제목은 "Learning-based approaches for Inverse Scattering Problems"입니다. 이 제목은 제 지도 교수님께서 지어주셨는데, 박사 학위 디펜스를 하면서 committee 교수님들께 학위 논문이 아니라 textbook에나 어울리는 제목이라고 좀 더 범위를 좁혀 수정을 하라는 지적을 다수 받았던 기억이 납니다.
** 그럼에도 불구하고 지도 교수님께서는 차라리 다른 imaging modality에 대한 연구를 추가로 할지언정 이 제목은 꿋꿋히 유지하라고 말씀하셨고, 결국에는 추가 연구를 더 해서 넣고 (하하하...orz...) 결국 제 학위 논문의 제목은 그대로 유지했습니다. 

오늘 소개할 내용은 제 학위 논문 제목에도 나와있는 inverse problem에 대한 얘기입니다. 그 중에서도 영상(image)에 대한 inverse problem에 대한 것으로 좀 더 좁게는 image restoration 문제에 대한 정리를 하고자 합니다.

Inverse Problems

An inverse problem in science is the process of calculating from a set of observations the causal factors that produced them: for example, calculating an image in X-ray computed tomography, source reconstruction in acoustics, or calculating the density of the Earth from measurements of its gravity field. It is called an inverse problem because it starts with the effects and then calculates the causes. It is the inverse of a forward problem, which starts with the causes and then calculates the effects.
어느 정도 감을 잡으셨을지 모르겠습니다만, 사실 committee 교수님들께서 제게 주셨던 의견들은 매우 온당한 것으로 inverse problem이라는 분야는 매우 광범위합니다. 위의 정의에서도 볼 수 있듯이 어떤 물리적 시스템을 묘사하는 문제를 forward modeling이라 한다면 그의 반대 방향을 모델링하고 연구하는 것을 inverse problem이라 할 수 있겠습니다.

하나의 예시로 아래와 같이 어떤 시스템 (e.g., 카메라)을 통과한 자연 이미지(latent original image)가 natural noise (e.g., additive white Gaussian noise, AWGN)뿐만 아니라 blurring 혹은 down-sampling과 같은 시스템의 특성으로 인한 degradation이 추가되어 관측된 이미지를 얻은 상황을 고려해보겠습니다:


이 때, 시스템 함수 혹은 operator $G$에 대한 물리적인 이해를 바탕으로 이를 찾거나 모델링하는 것을 forward problem이라 하고, 반대로 관측한 이미지를 바탕으로 깨끗한 원래 이미지를 찾는 문제를 inverse problem이라 합니다. 시스템에서 일어난 degradation에 따라서 각각 deblurring, denoising, super-resolution 등의 여러 영상 복원 (image restoration) 문제들로 세분화 될 수 있습니다.

Problem statement


General formulation


Image restoration을 수식적으로 모델링하는 방법은 매우 다양하겠으나, 측정 벡터 $y$가 임의의 선형 시스템 행렬 $H$와 가우시안 노이즈 (additive white Gaussian noise, AWGN)에 대해 $$y=Hx+v$$로 표현하는 것이 가장 일반적이며, 시스템 행렬 혹은 operator $H$가 어떤 것이냐에 따라 여러가지 영상 복원 문제가 모델링됩니다.

예를 들어 denoising은 $H=I$, deblurring (deconvolution)은 $H$가 convolution filter로 $Hx = k\circledast x$인 경우가 되며, inpainting은 $H$가 identity matrix이되 missing samples에 해당하는 부분이 듬성듬성 비어있는 degradation matrix로 모델링이 가능합니다. 또한 super-resolution은 $H$가 blur kernel과 sub-sampling (혹은 down-sampling)이 결합된 형태이며, 의료 영상 분야에서 사용되는 tomographic reconstruction은 $H$가 특정한 physical projections (e.g., Radon projections)이라 할 수 있겠습니다. 

영상에 가해진 degradation으로 인해 이를 되돌리는 것은 매우 "어려운데", 여기서 어렵다는 것은 image restoration (IR)은 "ill-posed" inverse problem (**)이라는 뜻입니다. 예를 들어 Single Image Super-Resolution (SISR)은 대표적인  ill-posed problem으로 방정식의 변수가 독립적으로 구성할 수 있는 식의 갯수보다 많은 경우입니다. 좀 더 구체적으로는 $H$의 row 수에 비해 column의 수가 훨씬 많기에 $x$의 해가 무한히 많을 수 있어서 진짜 $x^*$를 특정하기 어렵다는 것으로, 한 장의 저해상도 이미지에 대응할 수 있는 고해상도 이미지는 다양한 경우의 수가 있다는 예시로 이해하시면 쉽습니다.
** ill-posedness를 알고 싶다면 well-posed problem이 무엇인지를 알면 됩니다. 이는 wikipedia를 참고하시면 되겠습니다. 

특히나 natural image와 같이 전체 공간(search space)이 매우 큰 경우 해를 찾는 일이 더 지난하기 때문에, 가능한 해가 살고 있는 공간(solution space)을 좁히기 위해서 문제에 따라 시스템에 따라 적절한 constraint를 바탕으로 제약(regularize)을 걸어주는 방식을 취하게 됩니다. 따라서 관측된 데이터 $y$로부터 $x$를 구하기 위해서는 $$\min_x\frac{1}{2}||Hx-y||^2_2+\lambda\rho (x)$$를 푸는 것이 일반적이며 $\rho(x)$는 우리가 고른 regularization 항이 되겠습니다.

Bayesian perspective


이를 Bayesian 관점으로 표현하면, likelihood function $P(y|x)=exp(-\frac{1}{2\sigma^2}||y-Hx||^2_2)$에 적절한 image prior $P(x)$를 사용하여 $P(x|y)$를 구하는 maximum a posteriori (MAP) estimation으로 생각할 수 있습니다:$$\begin{align*} \hat{x} &=\arg\min_x\{-\log P(y|x)-\log P(x)\} \\ &= \arg\min_x\{\frac{1}{2\sigma^2}||y-Hx||^2_2+\lambda\rho(x)\}\end{align*}$$ 여기서 $\sigma^2$는 $\lambda$에 흡수될 수 있으므로 결과적으로 같은 형태가 된다는 것을 알 수 있죠.

이런 MAP framework로 IR 분야에 연구들을 살펴보면, image에 대한 prior를 어떤 것으로 정하느냐가 모델링의 주안점이 되어왔다는 것을 알 수 있습니다. 대표적인 image prior 모델로는 sparsity-inducing prior나 low-rank prior가 있겠으며, 이를 이용하여 optimization 문제를 푸는 전통적인 방식을 model-based optimization이라는 하나의 큰 카테고리로 묶을 수 있습니다.

한편 model-based optimization과는 조금 다른 갈래가 최근 트랜드인 deep learning입니다. 이를 MAP framework 관점에서 생각하면 deep learning 역시도 일종의 discriminative learning prior로써 image prior 모델링의 한 종류라고 생각할 수 있겠습니다.

지금부터는 이런 분류를 바탕으로 각 카테고리의 방식들을 하나씩 소개하겠습니다.

Sparse representation


많은 IR 알고리즘들이 sparsity prior를 사용하고 있습니다. 대표적인 예로는 total variation (TV)이 있으며, wavelet transform 이후 soft-thresholding을 하는 간단하지만 강력한 denoising 기법들이 있습니다. (이 방식은 natural image에 대한 wavelet domain representation이 일반적으로 sparse하다는 것을 근거로 합니다.)

또한 이미지 patch들이 sparse dictionary representation이 가능하다는 것 역시도 잘 알려진 사실이며 이를 이용하는 대표적인 알고리즘이 sparse coding입니다. IR에 대한 일반적인 sparse representation 모델은 overcomplete dictionary $D$와 이에 대응하는 coding (coefficients) vector $\alpha$에 $l_1$-norm을 취한 sparsity regularization이 더해진 형태입니다 (i.e., $\min_\alpha ||\alpha||_1$ s.t. $x=D\alpha$): $$\hat{\alpha}=\arg\min_\alpha||y-HD\alpha||+\lambda||\alpha||_1$$ 즉, sparse coding에서는 $x$에 대한 문제를 $\alpha$에 대한 estimation으로 문제를 바꾸어 풉니다. 

Sparse representation이 IR에서 성공적이었던 이유는 여러 가지로 방향으로 설명이 가능한데,
  1. Bayesian 관점에서 보면 sparsity prior를 이용하여 MAP 문제를 매우 잘 풀었다고 할 수 있고,
  2. neuroscience 측면에서 보면 실제로 인간의 primary visual cortex의 simple cells들이 들어오는 시각 신호에 대해 spatially localized, oriented 혹은 band-passed 형태로 각각 특화되어 있는데, wavelet filter를 사용한 sparsity-inducing representation이 이를 잘 모사하기 때문일 수도 있으며,
  3. compressed sensing 관점에서는 image patch들이 $k$-sparse한 신호들이라서 애초에 sparse optimization 형태로 가장 잘 풀 수 있는 문제이므로 여러 모로 성격이 잘 맞았다고 설명할 수도 있습니다. 

Sparse Dictionary Learning


Sparse representation 방식이 잘 통하려면 이를 표현할 atom들이 모인 dictionary를 잘 만드는 것이 가장 기본이 되겠습니다. 초기에는 DCT나 wavelets, curvelets 등을 사용한 analytical dictionary 구성이 주를 이루었으나 natural image의 복잡성을 충분히 표현하기에는 이런 hand-crafted analytical dictionary로는 한계가 있었습니다. 즉, 복잡한 이미지에 대해서는 더 많은 atom들이 필요했고 자연스럽게 sparseness가 떨어지는 문제가 있었죠.

이를 해결하기 위해 다음으로 연구된 것이 dictionary에 들어갈 atom들을 이미지들로부터 학습하는 것이었습니다. 즉, $Y=[y_1,\cdots,y_n]$과 같은 학습 샘플들이 있을 때, $m<n$인 atom을 갖는 dictionary $D=[d_1,\cdots, d_m]$을 $Y$로부터 배우되 $Y=D\Lambda,~\Lambda=[\alpha_1,\cdots, \alpha_n]$을 만족하는 code $\alpha$에 $l_0$-norm sparsity constraint를 주어 학습시킵니다. 여기서 $y_i$는 vectorized된 이미지 patch로 생각하시면 됩니다. 이 카테고리의 가장 대표적인 알고리즘으로는 K-SVD가 있습니다. 

Dictionary learning 방식은 analytically designed dictionary에 비해 특정 task나 data에 좀 더 adaptive한 표현이 가능했기에 일반적으로 더 좋은 성능을 보여주었고, multi-scale dictionary learning, double sparsity, adaptive PCA dictionaries, semi-coupled dictionary learning 등 다양한 알고리즘들이 개발되었으며 많은 연구 분야에서 애용되어 왔습니다. 

Low-rank minimization


Natural image에서 patch를 뽑으면 생각보다 패턴이 반복되는 경우가 많습니다. 이런 경험적인 지식을 바탕으로 non-local self-similarity (NSS) prior를 사용하는 연구들이 있는데요. 이런 방법들은 보통 이미지 내에 correlated patch들을 여러 장 모아 사용합니다. 각각의 이미지 patch를 따로따로 처리하는 sparse representation과는 확실히 다르다는 것을 알 수있습니다.

Non-local self-similarity in natural image

그림과 같이 이미지로부터 patch들을 뽑은 다음 column의 형태로 옆으로 쌓아 matrix 형태로 만들면, 이렇게 만든 matrix는 correlated patch들로 인해 low-rank한 특징을 갖게 됩니다.

이런 특징을 이용하는 IR 방법을 low-rank minimization이라 합니다. 예를 들어 이미지에 Gaussian noise가 더해지는 denoising 문제를 생각해보겠습니다. Noise는 패치들을 여럿 모은다고 해서 서로 correlate 할 이유가 없으므로 일반적으로 full-rank한 특성을 갖겠지만, 우리가 원하는 실제 이미지는 low-rank한 특성이 있을테니 데이터 행렬을 low-rank한 행렬로 approximation하므로써 denoising이 가능합니다. 즉, corrupted patch를 다른 patch로부터 수집한 redundant information을 바탕으로 수정하는 것이죠. 

문제는 행렬의 rank를 minimize하는 것이 매우 잘 알려진 NP-hard 문제라는 것입니다. 따라서 rank minimization 문제는 rank penalty의 convex relaxation인 nuclear norm을 사용해서 문제를 풀게 됩니다: $$\hat{X}=\arg\min_X ||Y-X||^2_F+\lambda||X||_*$$ 이 때, $X$의 nuclear norm은 $||X||_*=\sum_i||\sigma_i(X)||_1$로써 singular value의 합입니다. 이런 formulation의 장점은 문제의 closed-form solution이 존재한다는 것입니다. $Y=U\Sigma V^T$일 때, $$\hat{X}=US_{\frac{\lambda}{2}}(\Sigma)V^T$$이며, $S_{\frac{\lambda}{2}}(\Sigma)_{ii}=\max(\Sigma_{ii}-\frac{\lambda}{2},0)$으로 일종의 thresholding operator입니다. 이렇게 보면 행렬 $X$에 low-rankness도 다르게 말하면 행렬의 singular value들이 sparsely distribute할 것이라는 가정에서 시작하는 것이므로 sparsity prior라고 할 수 있겠습니다.

지금까지 매우 간결하게 Image restoration에서 사용되어 온 큰 줄기를 훑어보았는데요. 다음 글에서는 이런 model-based optimization 방식과는 좀 다른 결을 보여주는 learning-based approach를 소개하겠습니다.

간단히만 소개하자면, MAP estimation이라는 관점에서 discriminative learning 방식은 MAP inference를 predefined nonlinear function으로 대체하여 문제를 푸는 것으로 생각할 수 있습니다: $$\min_\theta l(\hat{x},x),~\text{s.t}~\hat{x}=\mathcal{F}(y,H;\theta)$$ 여기서 $\mathcal{F(\cdot)}$는 CNN이라고 생각하시면 됩니다.

이런 discriminative learning 방식은 model-based optimization 방식에 비해 유연성이 떨어지지만, 대신 test time에서 inference 속도가 빠르다는 장점이 있습니다. 이 외에도 여러 장단점과 특징이 있는데 왜 그러한 특징이 생기는지 등 자세한 것은 다음 글에서 다루겠습니다.

결국 하고 싶은 말은 deep learning을 사용하는 방식이 절대로 기존에 연구되어 온 많은 연구들과 완전 다른 길을 걷고 있는 것이 아니고, 이 역시도 크게는 image prior $P(x)$를 모델링하는 방식 중 하나라는 관점에서 설명할 수 있다는 것입니다.

그럼 곧 다음 글에서 뵙겠습니다.

다음 읽을 거리


2018년 9월 2일 일요일

[PR12-Video] 71. Categorical Reparameterization with Gumbel Softmax


TensorFlowKR facebook comunity에서 모인 12명의 paper readers (PR12)가 읽어주는 Deep learning paper awesome list 100선 by Terry Um.

#71. Categorical Reparameterization with Gumbel Softmax


이 리뷰에서는 NIPS 2016 workshop에 같이 발표되었고 최근 ICLR 2017에 발표된 두 편의 논문을 리뷰하겠습니다. 재미있는 점은 이 두 편의 논문들이 똑같은 아이디어를 바탕으로 정확히 같은 수식을 사용하여 arXiv에도 고작 하루 차이로 올라왔다는 것입니다. 아이디어가 공중에 떠다닌다는 말이 정말 맞는가 싶습니다. 즐겁게 들어주시면 감사하겠습니다.


(추신) 24분 부분에 질문 주신 부분에 대해 답이 미진한것 같아 끝나고 곰곰히 생각해본 답글을 여기에 추가합니다.  둘 다 categorical dist를 만드는데 다른 방법을 사용할 뿐이라는것이 맞는 답인것 같습니다. 우리가 nn으로부터 샘플링을 하고 싶으면 logit을 받아서 softmax를 통과시켜서 확률값을 얻어서 이를 바탕으로 분포에 값을 넣어주고 그 분포로부터 샘플을 뽑는 방법이 있겠구요 (이 방법이 준범님이 말씀하신 보통의 방식인 것 같습니다. 결국 마지막 단에서 softmax하여 확률 값을 주니까요) 다만 샘플링을 하지 않고 확률값 자체를 라벨과 빼서 에러를 계산하는데 사용되는 것이라 백프롭에서는 문제가 없는것 같습니다. 자기자신으로 1이니까 그렇다고 생각하는데 혹 이상하면 말씀주세요. 그리고 두번째 방법이 logit에 검벨에서 뽑은 노이즈를 더하여 argmax를 통과시켜서 값을 얻으면 그 자체가 discrete categorical dist에서 나온 샘플입니다. 여기서 argmax를 softmax로 relaxation한 것이 gumbel softmax trick이구요 그래서 이렇게 복잡하게 과정을 거친 이유는 말씀드린 바와 같이 미분이 가능하게 해서 중간에 node가 껴있을때 gradient를 계산하기 위해서인 것으로 이해하면 되지 않을까 싶습니다.

(paper1) Categorical Reparameterization with Gumbel Softmax and
(paper2) The Concrete Distribution: A Continuous Relaxation of Discrete Random Variables

Paper1: https://arxiv.org/abs/1611.01144
Paper2: https://arxiv.org/abs/1611.00712
슬라이드: https://www.slideshare.net/thinkingfactory/pr12-categorical-reparameterization-with-gumbel-softmax

다음에 또 다른 주제로 뵈어요~!

다른 분들의 발표도 보고 싶다면: PR12 딥러닝 논문읽기 모임

다음 읽을거리